Une puce IA OpenAI pourrait réduire certains coûts et limiter les tensions d’approvisionnement. Mais son lancement effectif, ses usages et ses performances restent à confirmer.
Les GPU demeurent essentiels pour entraîner les grands modèles. Une puce dédiée pourrait surtout accélérer les réponses quotidiennes, sans créer une indépendance matérielle complète.
OpenAI a-t-il réellement lancé une puce IA ?
À ce stade, rien ne permet d’affirmer qu’une puce IA OpenAI est un produit lancé et déployé à grande échelle. Sans annonce officielle précise ni sources fiables concordantes, le terme de « lancement » doit donc être employé avec prudence.
Plusieurs réalités très différentes peuvent se cacher derrière un projet matériel. Une entreprise peut concevoir une puce en interne, tester un prototype ou commander des composants à un partenaire. Elle peut aussi préparer une intégration dans ses centres de données. Aucun de ces cas ne signifie qu’un produit fonctionne déjà pour les utilisateurs.
Pour mesurer la portée d’une éventuelle initiative, il faudrait connaître les usages visés, le fabricant, le calendrier et les volumes concernés. Les performances, la consommation électrique et la mémoire disponible seraient aussi essentielles pour juger cette puce dédiée à l’IA.
Pourquoi les GPU restent essentiels pour l’intelligence artificielle
Les GPU pour intelligence artificielle exécutent de très nombreux calculs en parallèle. Cette capacité convient aux opérations mathématiques répétées utilisées par les grands modèles. Ils servent à entraîner les modèles IA, mais aussi à les faire fonctionner auprès du public.
Ces composants ne sont pas interchangeables comme de simples pièces de serveur. Leur valeur repose aussi sur les logiciels, les outils de programmation et les systèmes qui relient des milliers de puces. Les équipes peuvent ainsi adapter leurs méthodes et tester de nouveaux modèles sans changer toute leur infrastructure.
Une puce spécialisée peut être plus efficace sur une tâche définie. En contrepartie, elle offre souvent moins de souplesse qu’un GPU généraliste. Le bon choix dépend donc du type de calcul, du volume de demandes et des contraintes de coût.
L’entraînement et l’inférence n’ont pas les mêmes besoins
L’entraînement consiste à créer ou à mettre à jour un modèle à partir de grandes quantités de données. Il demande beaucoup de puissance, de mémoire et des échanges très rapides entre les machines. Cette étape évolue souvent, ce qui favorise des matériels polyvalents.
L’inférence IA correspond à l’usage quotidien du modèle. Lorsqu’un service génère une réponse, traduit un texte ou produit une image, il réalise de l’inférence. Les requêtes y sont plus répétitives, ce qui facilite l’emploi d’accélérateurs spécialisés.
À très grande échelle, le coût par requête devient décisif. Une légère baisse de consommation ou de temps de calcul peut avoir un effet majeur sur les dépenses d’exploitation.
Une puce maison peut-elle réduire la dépendance aux GPU ?
Une puce propriétaire pourrait réduire une partie de la dépendance aux GPU, surtout pour des tâches stables et très fréquentes. L’objectif serait de mieux maîtriser le coût de calcul IA, la consommation électrique et la disponibilité du matériel.
Elle pourrait, par exemple, prendre en charge une part de l’inférence IA, tandis que les GPU resteraient utilisés pour l’entraînement et les travaux plus complexes. Cette approche ne remplace pas nécessairement le parc existant. Elle répartit les charges selon les points forts de chaque composant.
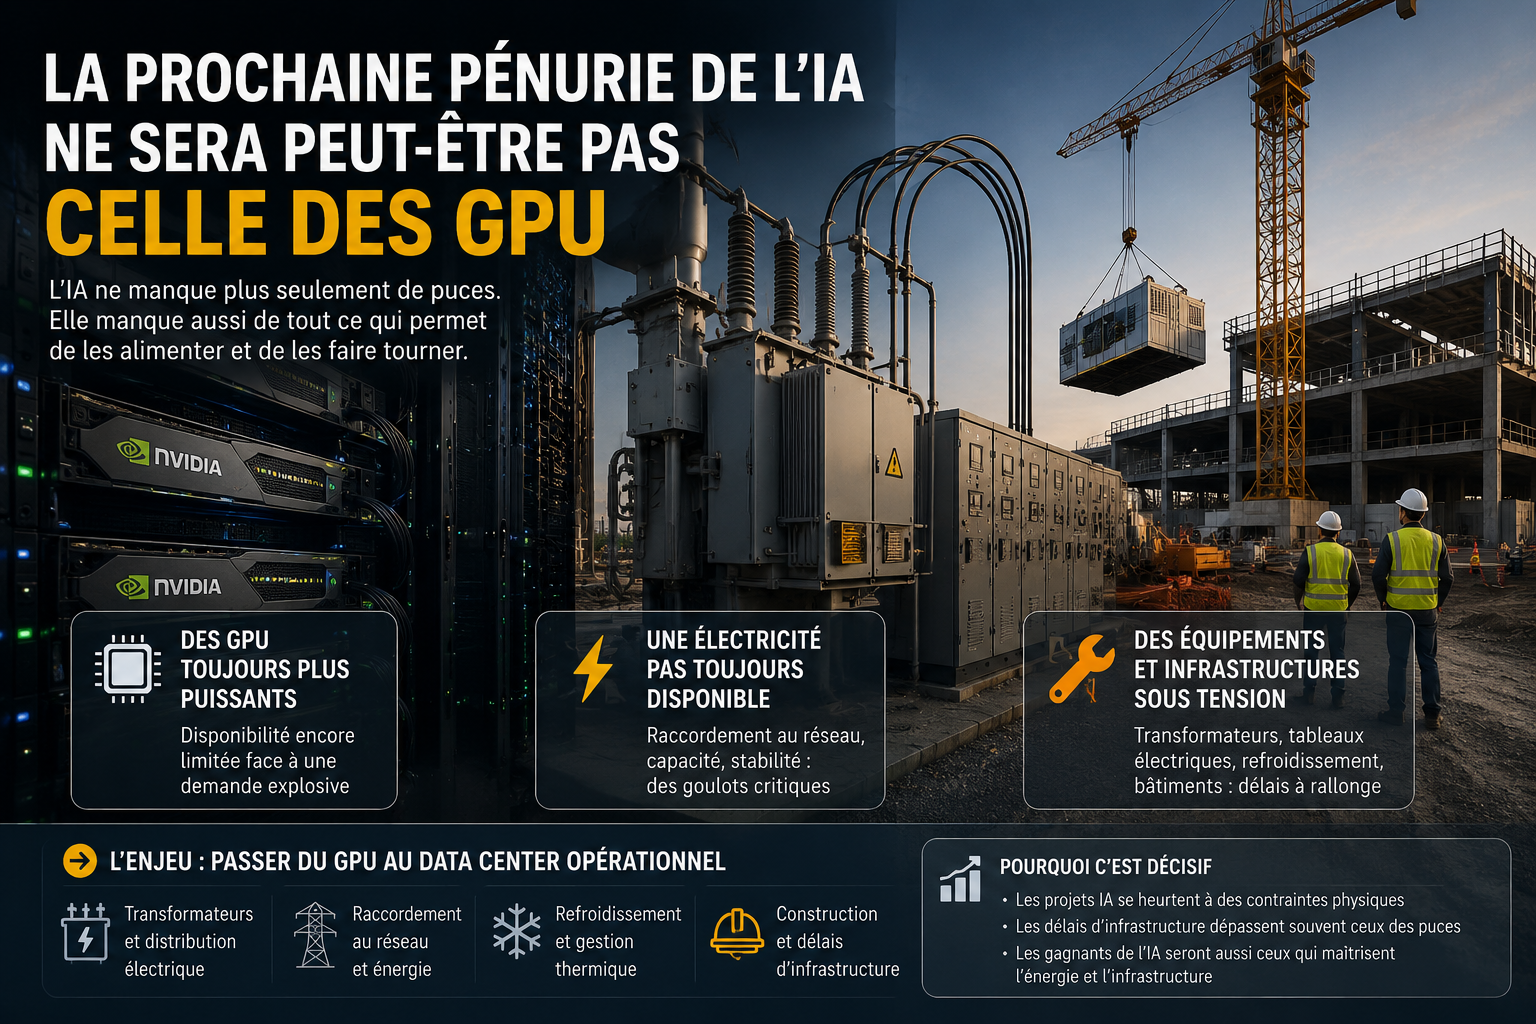
Concevoir la puce ne suffit toutefois pas. Il faut encore de la mémoire rapide, des réseaux performants, des serveurs adaptés et des logiciels fiables. La fabrication dépend aussi d’industriels capables de produire les semi-conducteurs pour IA en quantité suffisante.
Il faut donc distinguer trois niveaux : réduire les achats de GPU, diversifier les fournisseurs et devenir réellement indépendant. Une autonomie complète sur le matériel reste bien plus difficile à atteindre.
Ce que cette stratégie pourrait changer pour les services d’IA
Une meilleure maîtrise du matériel pourrait améliorer les marges d’un fournisseur de services d’IA. Elle pourrait aussi permettre de servir davantage de demandes avec la même infrastructure. Cela ne garantit pourtant pas une baisse immédiate des prix pour les utilisateurs.
Les grands acteurs cherchent surtout à limiter leur exposition aux pénuries et aux coûts variables des composants. Disposer de plusieurs types d’accélérateurs peut renforcer leur capacité à déployer des services, même lorsque certains GPU deviennent difficiles à obtenir.
La concurrence pourrait alors se jouer davantage sur l’ensemble de la chaîne technique. La puce compte, mais la mémoire, le réseau, les centres de données et les logiciels comptent tout autant. Une solution matérielle efficace doit fonctionner avec cet ensemble.
Les effets réels ne pourront être évalués qu’avec des comparaisons complètes. Il faudra examiner les tâches testées, la vitesse, la consommation, la mémoire et le coût total d’exploitation. Sans ces données, annoncer la fin des GPU serait prématuré.
Une puce IA OpenAI ne peut donc être considérée comme lancée sans confirmation officielle et données techniques vérifiables.
Si le projet se concrétise, il pourrait réduire certains coûts d’inférence, sans remplacer rapidement les GPU. La prochaine étape sera d’évaluer son déploiement réel.